شبکههای عصبی چگونه کار میکنند: چرا خطوط صاف کافی نیستند
یک معادله خط راست نقطه شروع خوبی برای درک نحوه کارکرد شبکه عصبی است. این همان چیزی است که در مقاله قبلی من، «شبکههای عصبی چگونه کار میکنند – توضیح داده شده با استفاده از معادله خط راست E» بررسی کردیم.
یک معادله خط راست نقطه شروع خوبی برای درک نحوه کارکرد شبکه عصبی است. این همان چیزی است که در مقاله قبلی من، «شبکههای عصبی چگونه کار میکنند – توضیح داده شده با استفاده از معادله خط راست (y=ax+b)» بررسی کردیم.
اما، اگر رابطه بین ورودی و خروجی خطی نباشد چه؟
همه ما میدانیم که در دنیای واقعی، دادهها همیشه از الگوی خط صاف پیروی نمیکنند. اینجاست که همهچیز جالب میشود: گاهی اوقات یک قانون واحد برای توصیف رابطه بین متغیرها کافی نیست.
اینجاست که غیرخطی بودن (Non-linearity) وارد میدان میشود. این ویژگی به شبکههای عصبی اجازه میدهد تا رفتارهای متغیر را در دادهها ثبت کنند.
در این مقاله، مفهوم غیرخطی بودن را بررسی خواهیم کرد که میتواند روابط پیچیده را در دادهها ثبت کند. با استفاده از یک مثال ساده، تلاش خواهیم کرد منحنیهای خطی تکهتکه (Piecewise linear curves)، توابع ReLU، منحنیهای S شکل و توابع سیگموئید (Sigmoid functions) را در ارتباط با اینکه چگونه به شبکههای عصبی در یادگیری الگوهایی که یک خط صاف نمیتواند توصیف کند کمک میکنند، درک کنیم.
فهرست مطالب
- پیشنیازها
- چه زمانی یک خط صاف کافی است
- چه زمانی یک خط صاف کافی نیست منحنی خطی تکهتکه تابع ReLU چیست؟ منحنی S شکل تابع سیگموئید چیست؟
- منحنی خطی تکهتکه
- تابع ReLU چیست؟
- منحنی S شکل
- تابع سیگموئید چیست؟
- مدلسازی یک شبکه عصبی عمیق پیشبینی نمرات با استفاده از ReLU پیشبینی قبولی/ردی با استفاده از ReLU و سیگموئید
- پیشبینی نمرات با استفاده از ReLU
- پیشبینی قبولی/ردی با استفاده از ReLU و سیگموئید
- افکار نهایی
پیشنیازها
- درک پایهای از توابع خطی
- آشنایی با مفهوم شبکههای عصبی عمیق
چه زمانی یک خط صاف کافی است
معادله خط راست به این معناست که یک قانون ثابت در سراسر رابطه برقرار است.
y = ax + b
    y => Output variable
x => Input variable
a => Amount by which y changes when x changes (slope)
b => Value of y when x is 0 (y intercept)
برای درک بهتر میتوانیم به یک مثال نگاه کنیم.
خانم پولی یک معلم ریاضی است که میخواهد برنامهای مطالعاتی برای دانشآموزانش طراحی کند تا به آنها کمک کند در امتحان نهایی موفق شوند. او یک قانون سرانگشتی با استفاده از یک عامل ایجاد میکند: تعداد ساعتهای مطالعه در هفته. این یعنی نمره کسبشده توسط دانشآموز مستقیماً با ساعات صرفشده برای مطالعه متناسب است.
بر اساس فرض خود، او معادلهای به شکل y=ax+b ارائه میدهد.
    y => Marks scored
x => Number of hours studied
a => Increase in marks for every hour studied
b => Minimum marks every student is capable of scoring without studying.
بنابراین، پس از یک امتحان فصلی، او با دانشآموزان خود مصاحبه میکند و اطلاعاتی درباره تعداد ساعتهایی که در هفته ریاضی مطالعه کردهاند جمعآوری میکند. او جدولی با دو ستون ایجاد میکند: تعداد ساعات مطالعه (x) در هفته و نمرات کسبشده (y) و آنها را روی نمودار ترسیم میکند.
| تعداد ساعات مطالعه | نمرات کسبشده |
|---|---|
| 0 | 40 |
| 1 | 40 |
| 2 | 41 |
| 3 | 40 |
| 4 | 48 |
| 5 | 58 |
| 6 | 69 |
| 7 | 80 |
| 8 | 80 |
اما وقتی او سعی میکند فرمول ساده خود را اعمال کند، به نظر میرسد با دادههایی که جمعآوری کرده همخوانی ندارد و این ثابت میکند که دادههای دنیای واقعی به ندرت به این سادگی هستند.
چه زمانی یک خط صاف کافی نیست
خانم پولی نمودار را به دقت بررسی کرده و چند الگو را شناسایی میکند. دانشآموزانی که فقط چند ساعت مطالعه میکنند ممکن است پیشرفت زیادی نبینند. هنگامی که از یک نقطه خاص عبور میکنند، نمراتشان با مطالعه بیشتر شروع به افزایش میکند. و دوباره پس از یک نقطه مشخص، نمرات تقریباً ثابت میمانند.
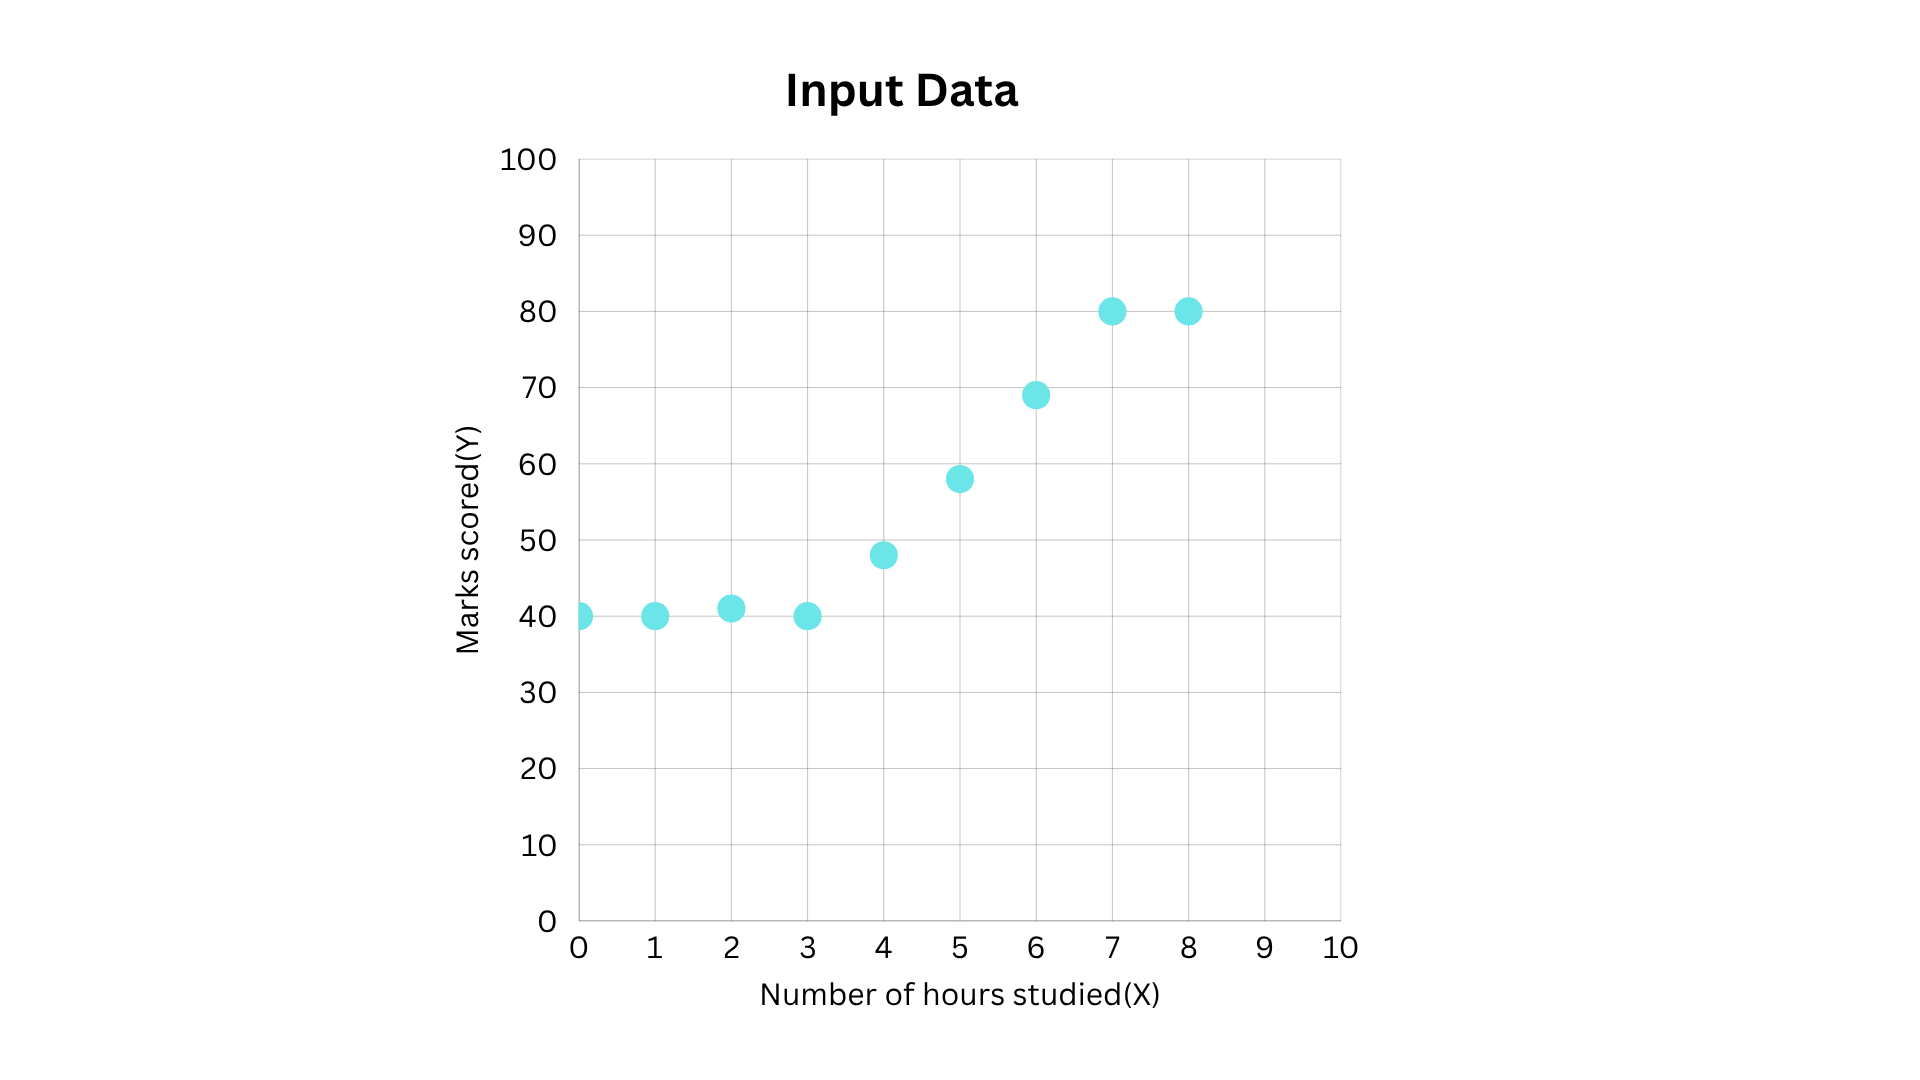
بنابراین، معادله خط راست ساده خانم پولی برای توصیف رابطه بین تعداد ساعات مطالعه (x) در هفته و نمرات کسبشده (y) کافی نیست.
در عوض، میتوان آن را به سه بخش تقسیم کرد،
    Less than t₁ hours: Marks remain constant
t₁ to t₂ hours: Marks increase with study time
More than t₂ hours: Marks remain constant
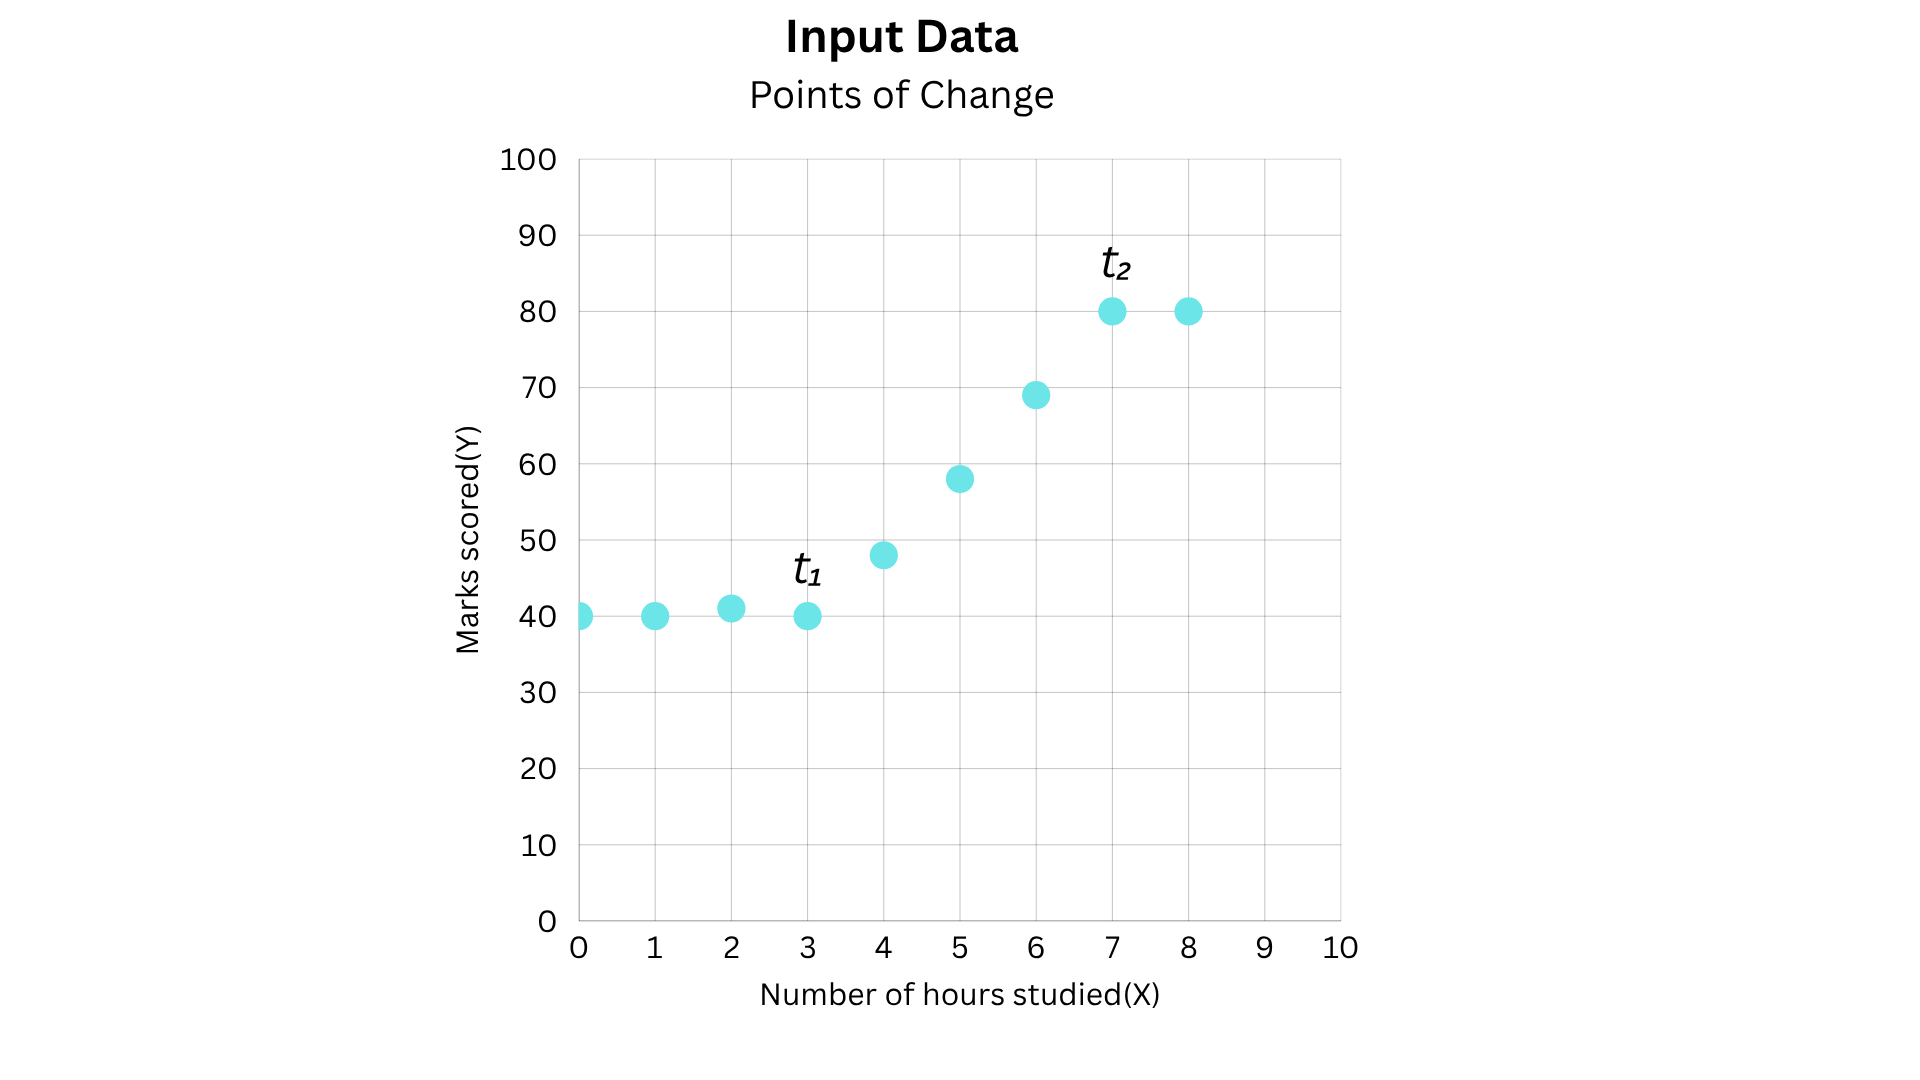
بنابراین، او میتواند برای هر بازه معادلات جداگانهای داشته باشد و آنها را به این صورت بنویسد:
    y = 1st equation, x<t₁
y = 2nd equation, t₁<=x<t₂
y = 3rd equation, x>=t₂
این مثال اولین نگاه ما به پدیده غیرخطی بودن را فراهم میکند. تغییراتی در رابطه در نقاط خاصی وجود دارد، بنابراین یک معادله خط راست واحد ناکافی است زیرا رفتار باید در نقاط مختلف تغییر کند.
یک راه ساده برای مدیریت این موضوع استفاده از یک تابع خطی تکهتکه است.
منحنی خطی تکهتکه
برای شروع و به منظور سادگی، خانم پولی تصمیم میگیرد تنها دو ناحیه را در نظر بگیرد.
    Region1: Hours of study < t₁
Region2: Hours of study >= t₁
مقادیر در ناحیه اول حول یک مقدار خاص نوسان میکنند. با وجود اینکه آنها کاملاً روی یک خط قرار ندارند، او میتواند یک تقریب بزند و آن ناحیه را به شکل یک خط با شیب صفر (slope=0) نمایش دهد. این نشان میدهد که نمرات تقریباً ثابت میمانند.
در ناحیه دوم، به نظر میرسد که شیب مثلی وجود دارد. بنابراین او معادله خط دیگری را برای آن خط با شیب تند رو به بالا در نظر میگیرد.
خانم پولی در نهایت برای نمودار بالا به دو معادله میرسد؛ زیرا یک معادله نمیتواند آن را تعریف کند. با تغییر الگو، قانون نیز برای بازههای مختلف تغییر میکند.
بنابراین، او میتواند آن را به شکل زیر بنویسد:
    y = 1st equation, x<t₁
y = 2nd equation, x>=t₁
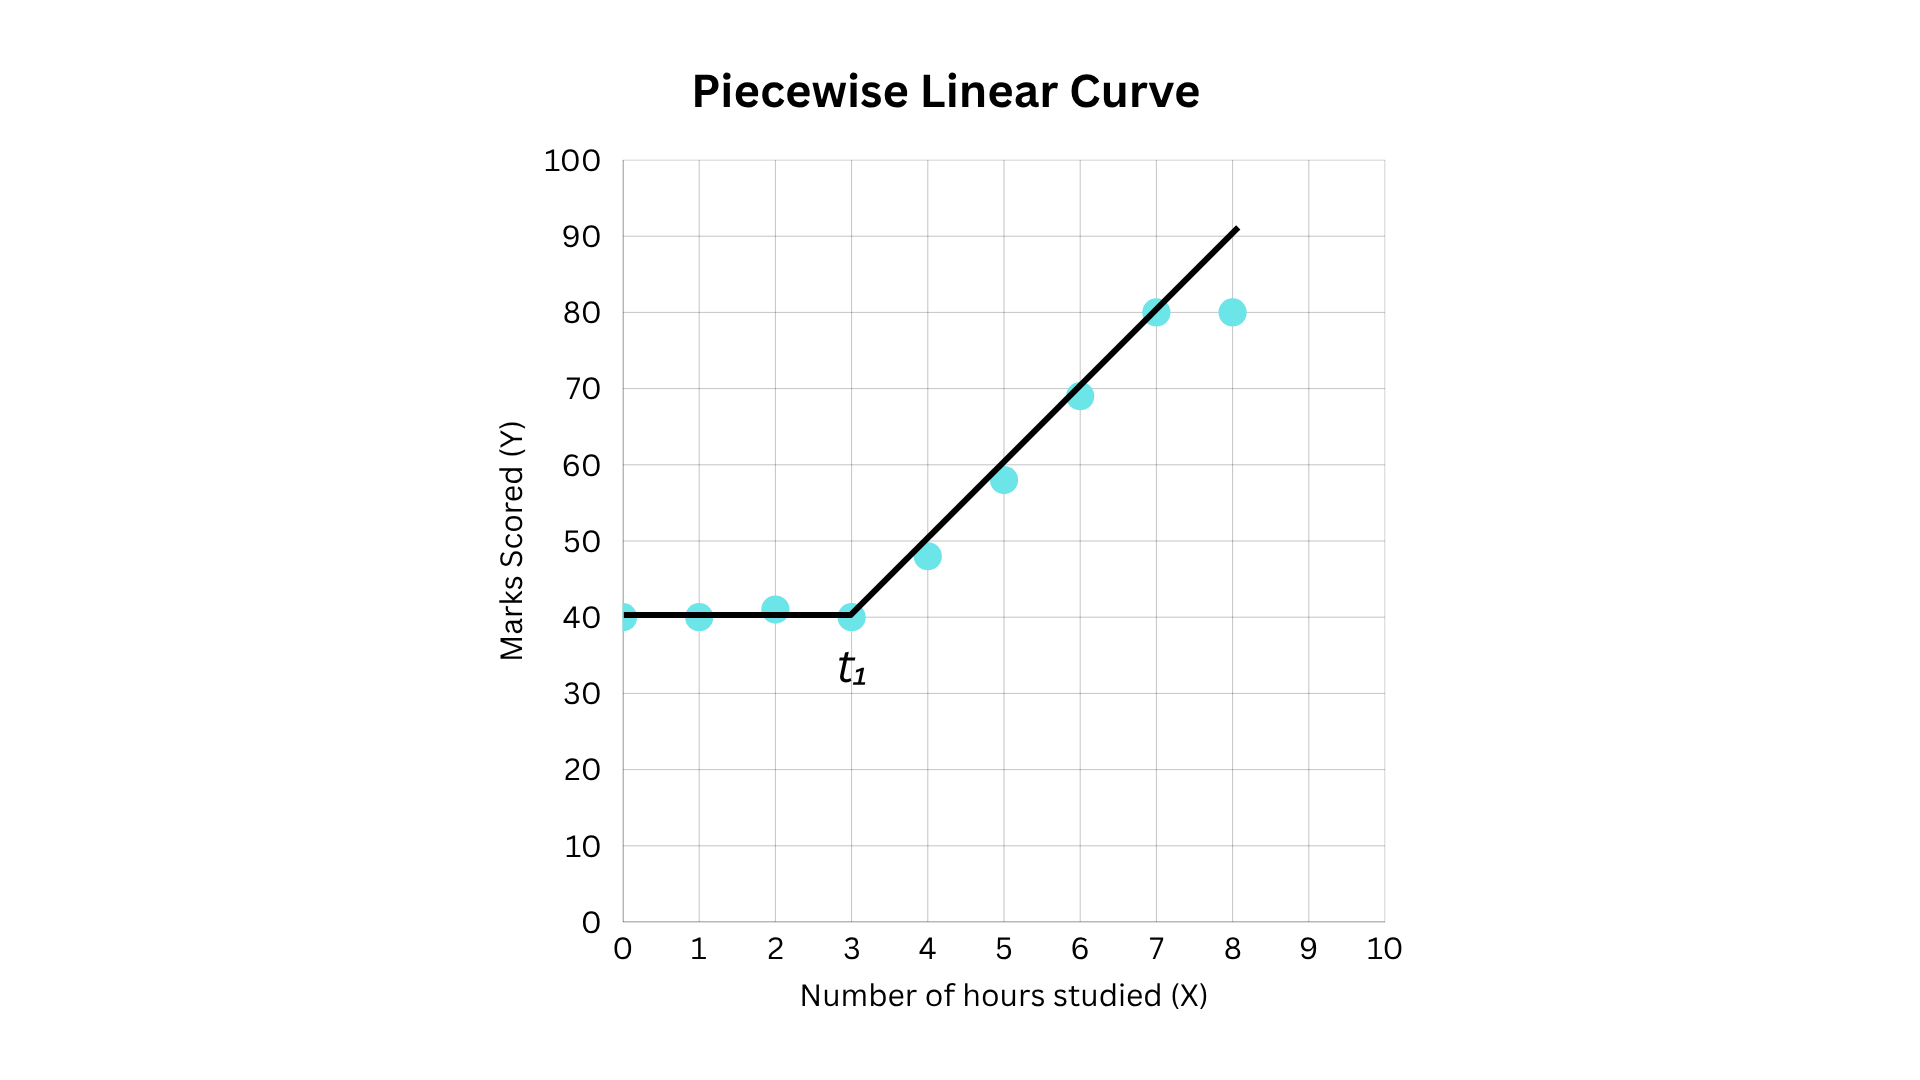
به طور جداگانه، اینها ممکن است شبیه معادلات خط راست به نظر برسند. اما وقتی در کنار هم قرار میگیرند، رابطه کلی دیگر یک خط راست نیست. وقتی x از یک مقدار مشخص عبور میکند، معادله تغییر میکند. به این تابع، تابع خطی قطعهای (piecewise linear function) گفته میشود. این تابعی است که از قوانین مختلفی برای بازههای مختلف ورودی تشکیل شده است.
این ایده در یکی از پرکاربردترین توابع فعالسازی در شبکههای عصبی یعنی ReLU ظاهر میشود.
تابع ReLU چیست؟
عبارت ReLU مخفف Rectified Linear Unit (واحد خطی اصلاحشده) است. از نظر ریاضی، به این صورت است:
y = ReLU(x) = max(0,x)
این تابع ورودیهای مثبت را بدون تغییر نگه میدارد و ورودیهای منفی را به صفر تبدیل میکند.
در اینجا نیز بخشهای فردی خطی هستند اما تابع کلی غیرخطی است. بنابراین، ReLU یک تابع خطی قطعهای است که غیرخطی بودن را وارد مدل میکند.
نمودار زیر تابع ReLU را نشان میدهد:
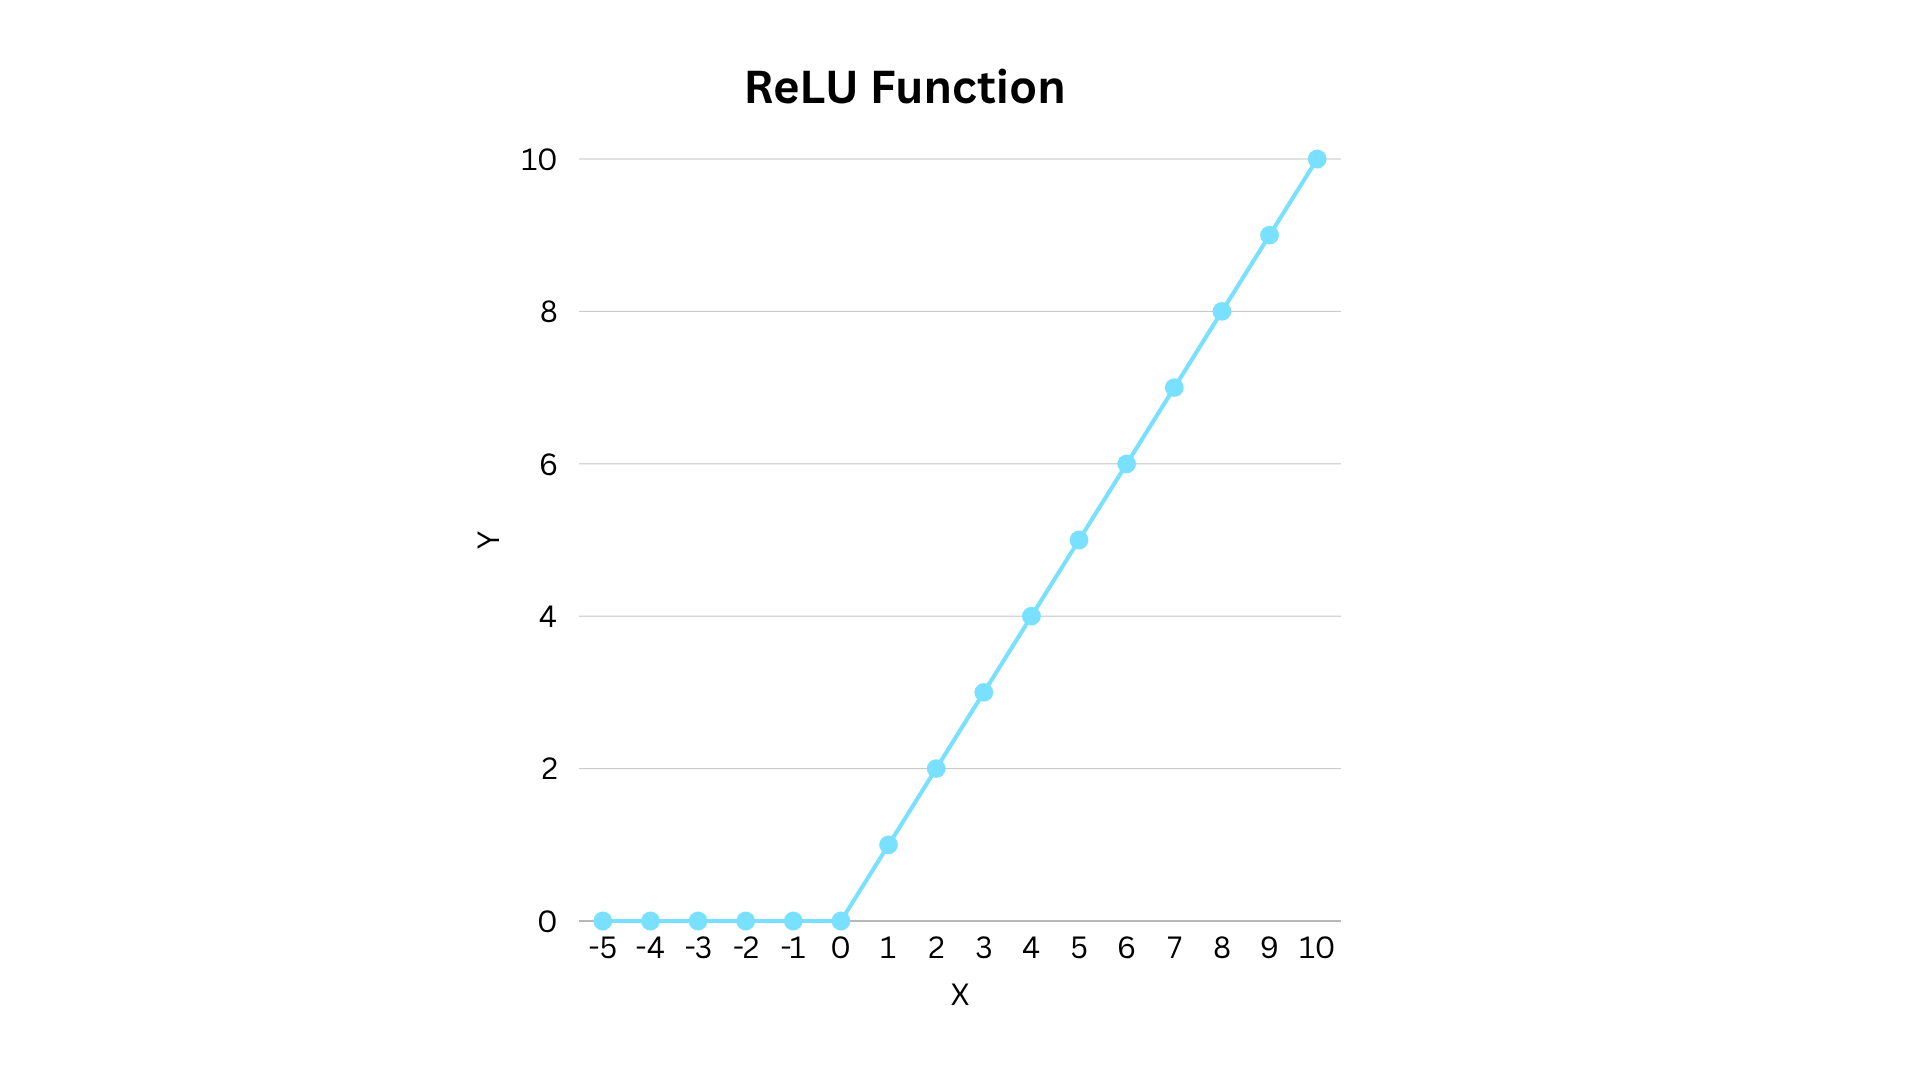
این تغییر ساده در رفتار به یک نورون اجازه میدهد تا به بازههای مختلف ورودی واکنش متفاوتی نشان دهد و به شبکههای عصبی راهی میدهد تا فراتر از یک رابطه تکخطی حرکت کنند.
منحنی S شکل
اکنون، یک منحنی خطی قطعهای کار را انجام میدهد، اما خانم پولی میبیند که گذار از یک ناحیه به ناحیه دیگر نسبتاً تند است. او همچنین برای سادگی تنها دو ناحیه را در نظر گرفته بود، با اینکه توزیع را میتوان به سه ناحیه تقسیم کرد.
بنابراین، او یک منحنی هموار میکشد که تقریباً از تمام نقاط عبور میکند، همانطور که در زیر نشان داده شده است:
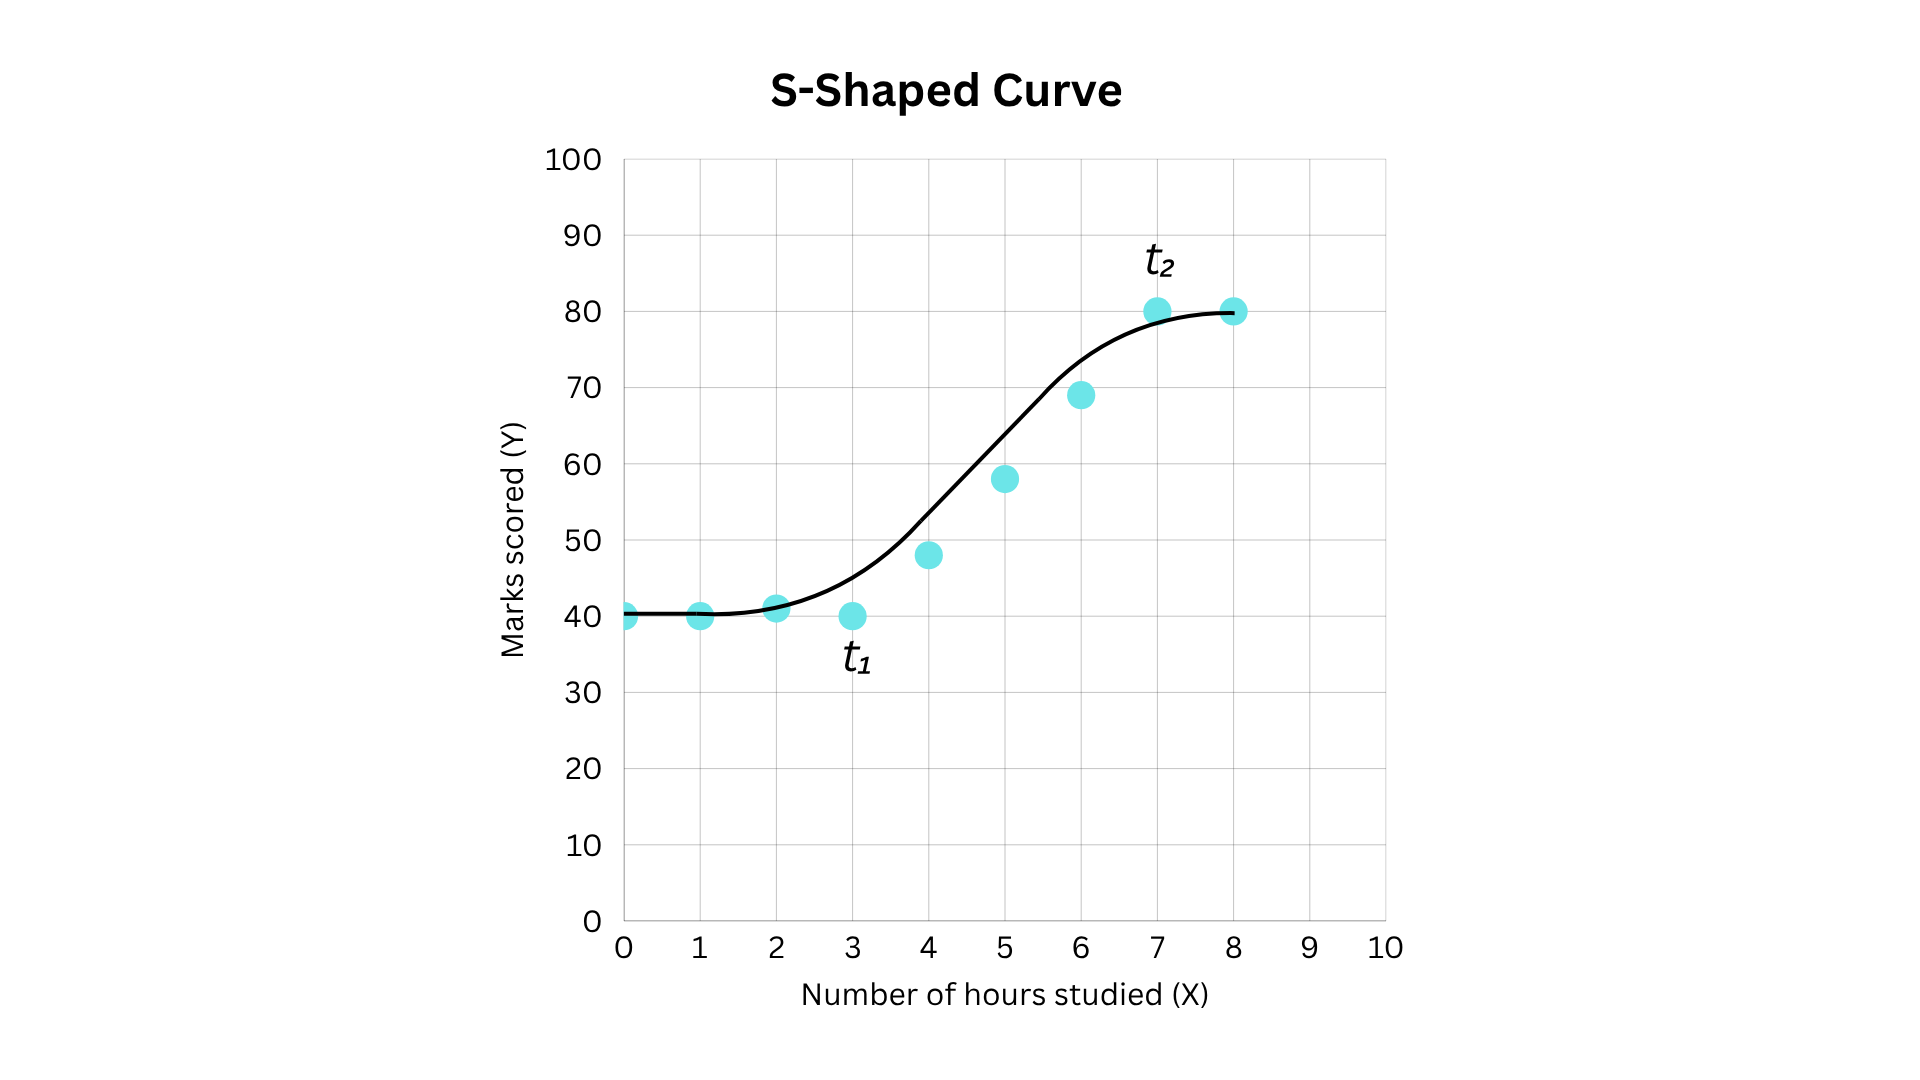
این شکل نشان میدهد هنگامی که یک دانشآموز تا t₁ ساعت مطالعه میکند، نمرات تقریباً ثابت میمانند. سپس، افزایش ساعات مطالعه از t₁ به t₂، نمرات کسبشده را افزایش میدهد، بنابراین شیب وجود دارد. در نهایت در t₂، دوباره مسطح میشود. این گذار برخلاف منحنی خطی قطعهای که جهتها را با استفاده از خطوط راست ساده تغییر میدهد، تدریجی و پیوسته است.
منحنیای که خانم پولی کشید یک الگوی تصادفی نیست. این منحنی را میتوان از نظر ریاضی نیز نمایش داد. یکی از توابعی که این نوع شکل را ایجاد میکند، تابع سیگموئید (sigmoid function) است.
تابع سیگموئید چیست؟
تابع سیگموئید یک فرمول ریاضی است که هر ورودی با مقدار واقعی را میگیرد و آن را به مقادیر بین 0 و 1 نگاشت میکند. این تابع به آرامی از مقادیر نزدیک به 0 افزایش مییابد، در وسط به سرعت بالا میرود و به تدریج در مقادیر نزدیک به 1 هموار میشود.
y = σ(x) = 1 / (1 + exp(-x))
نمودار زیر تابع سیگموئید را نشان میدهد:
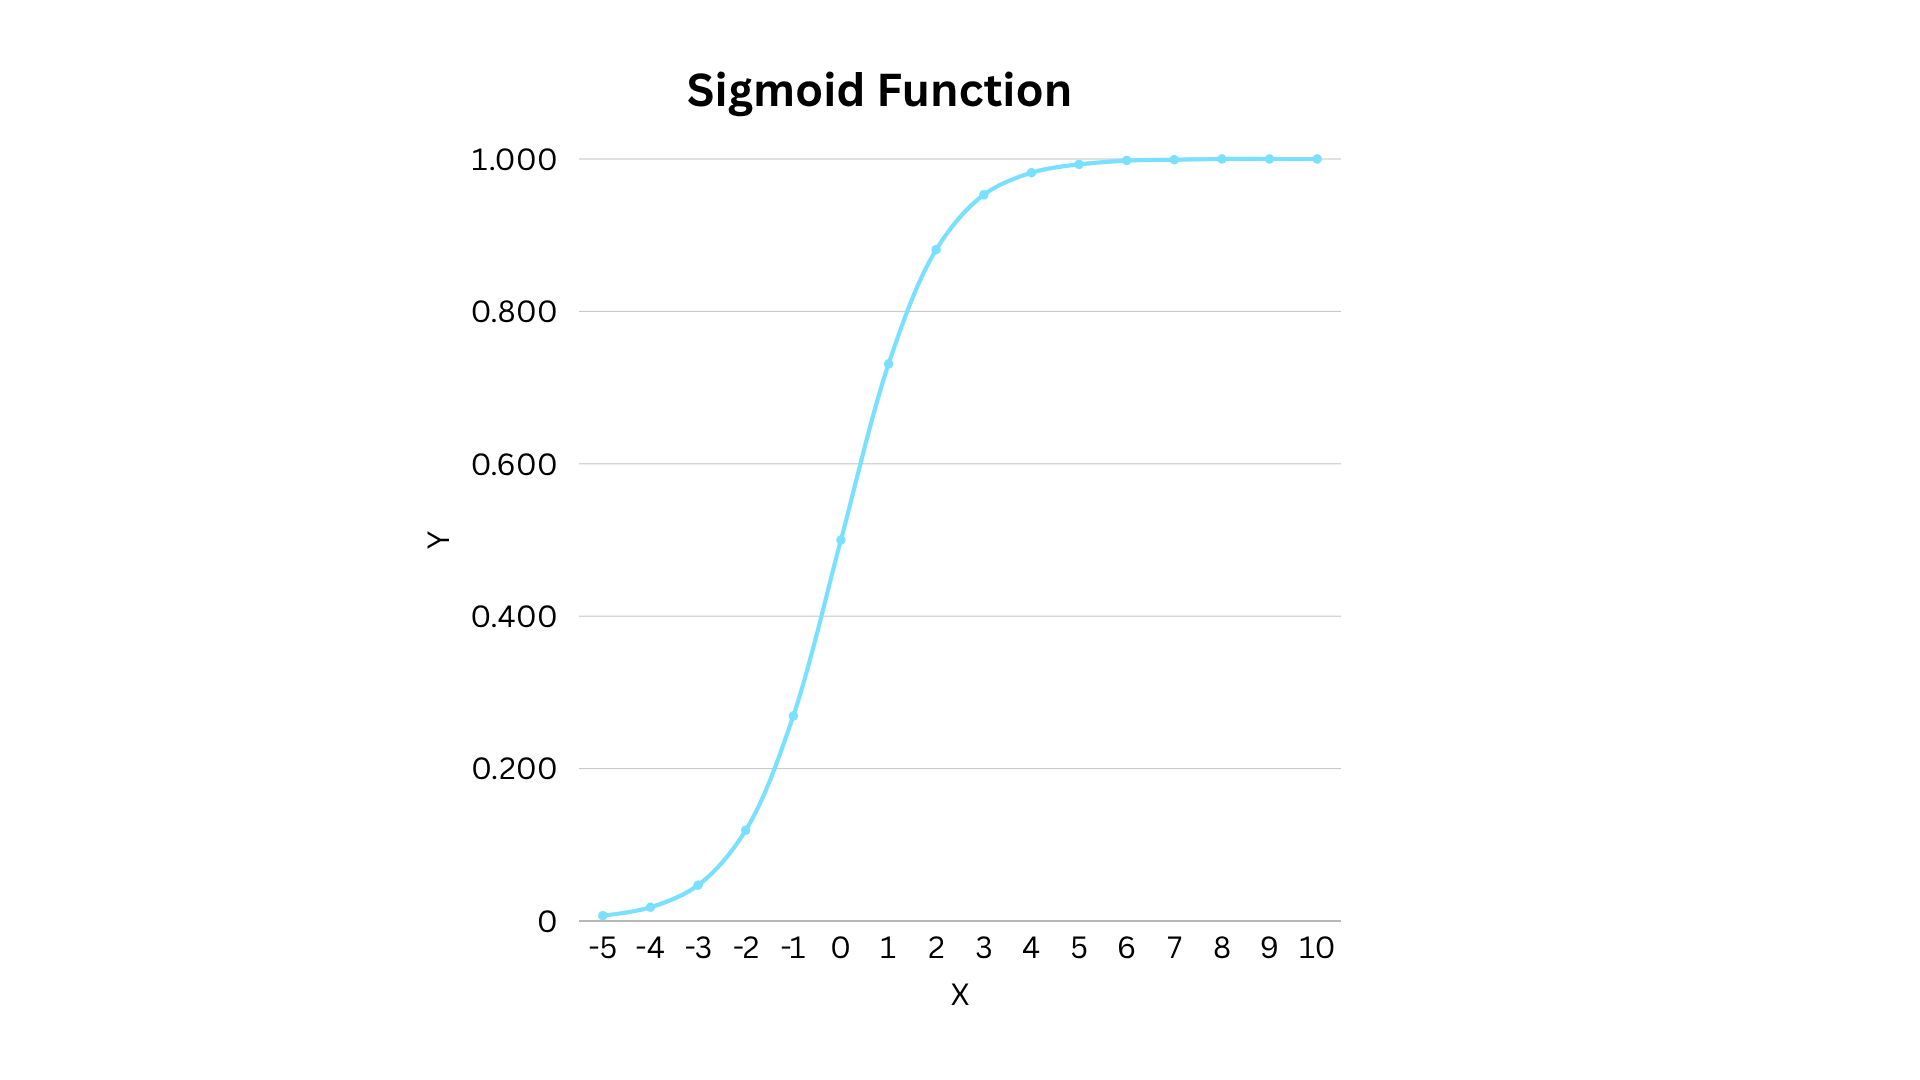
تابع سیگموئید در شبکههای عصبی اهمیت دارد زیرا در عین محدود کردن خروجی بین 0 و 1، خاصیت غیرخطی بودن را نیز وارد میکند. این امر زمانی مفید است که خروجی نیاز به نمایش یک احتمال داشته باشد، مانند احتمال قبولی یک دانشآموز در امتحان. خروجی سیگموئید بالاتر نشاندهنده احتمال بیشتر قبولی دانشآموز است و بالعکس.
مدلسازی یک شبکه عصبی عمیق
خانم پولی اکنون باید مفاهیم معادلات خطی و غیرخطی را ترکیب کند تا یک شبکه عصبی عمیق را مدلسازی کند. او باید دو رویکرد جداگانه را اتخاذ کند تا:
- نمرات کسبشده در امتحان را پیشبینی کند
- قبولی/رد شدن در امتحان را پیشبینی کند
او از دو شبکه عصبی آموزشندیده بسیار ساده با وزنها و بایاسهای انتخابشده دستی برای هر کدام استفاده میکند. او صرفاً برای نشان دادن نحوه کارکرد محاسبات، این را امتحان میکند. در واقعیت، او پارامترها را خودش انتخاب نمیکند. او شبکه را با وزنها و بایاسهایی تنظیم میکند که در طول آموزش با مقایسه مکرر مقادیر پیشبینیشده با مقادیر واقعی و تنظیم پارامترها برای به حداقل رساندن خطا، یاد گرفته میشوند.
پیشبینی نمرات با استفاده از ReLU
مقدمه #1: تنظیم شبکه
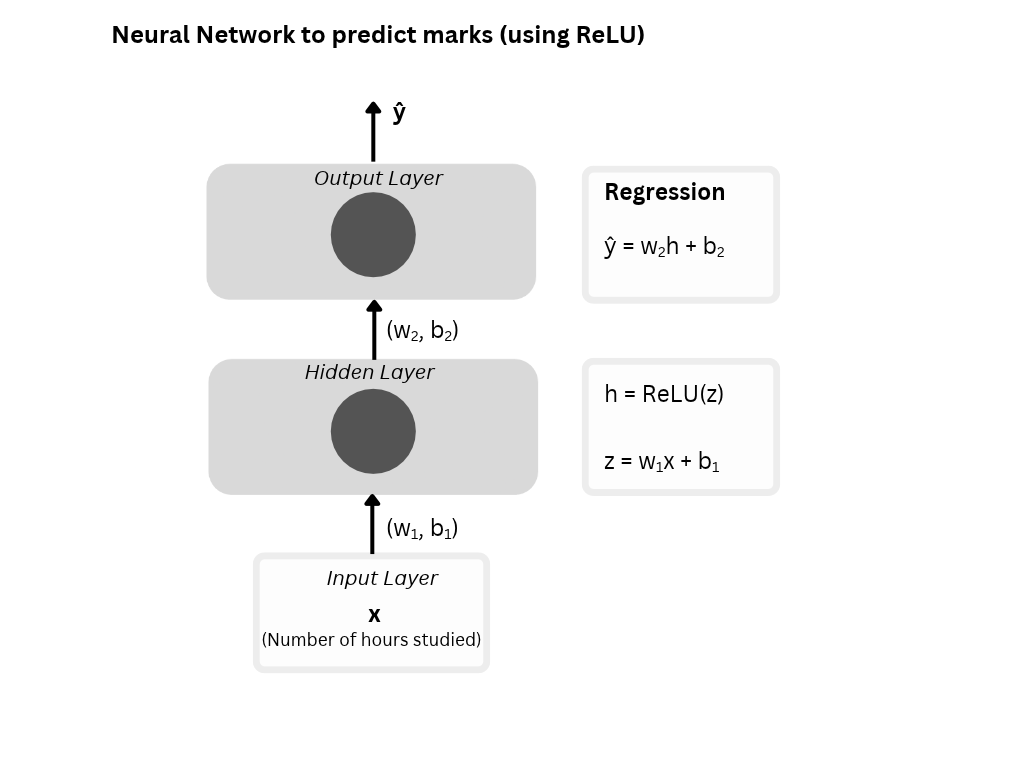
خانم پولی شبکه عصبی عمیق را با معادلات ساده به روش زیر راهاندازی کرده است:
- لایه ورودی: تعداد ساعات مطالعه (x) در اینجا دریافت میشود.
- لایه پنهان: تبدیل خطی و ReLU روی ورودی اعمال میشود. z = w₁x + b₁ = x - 3 (w₁=1, b₁=-3) h = ReLU(z) = max(0, z)
- لایه خروجی: نمره کسبشده پس از اعمال یک تبدیل خطی روی خروجی لایه پنهان (h) پیشبینی میشود. ŷ = w₂h + b₂ = 10h + 40 (w₂=10, b₂=40)
مقدمه #2: محاسبه نمرات پیشبینیشده
فرض کنید او میخواهد نمرات کسبشده توسط دانشآموزی که 5 ساعت مطالعه کرده است را محاسبه کند. کار او به این شکل است:
    z = w₁x + b₁, = x - 3 = 5 - 3 = 2
h = ReLU(z) = max(0, z) = max(0, 2) = 2
در نهایت نمرات پیشبینیشده را محاسبه کنید:
ŷ = w₂h + b₂ = 10h + 40 = 10(2) + 40 = 60
شبکه عصبی نمره 60 را پیشبینی میکند در حالی که نمره واقعی در مجموعه داده 58 است.
مقدمه #3: مقایسه پیشبینیها با نمرات واقعی
پس از اینکه خانم پولی تمام نمرات پیشبینیشده توسط شبکه عصبی را به دست آورد، آنها را با دادههای واقعی در جدول زیر مقایسه میکند:
| تعداد ساعات مطالعه | نمرههای کسبشده | نمرههای پیشبینیشده |
|---|---|---|
| 0 | 40 | 40 |
| 1 | 40 | 40 |
| 2 | 41 | 40 |
| 3 | 40 | 40 |
| 4 | 48 | 50 |
| 5 | 58 | 60 |
| 6 | 69 | 70 |
| 7 | 80 | 80 |
| 8 | 80 | 90 |
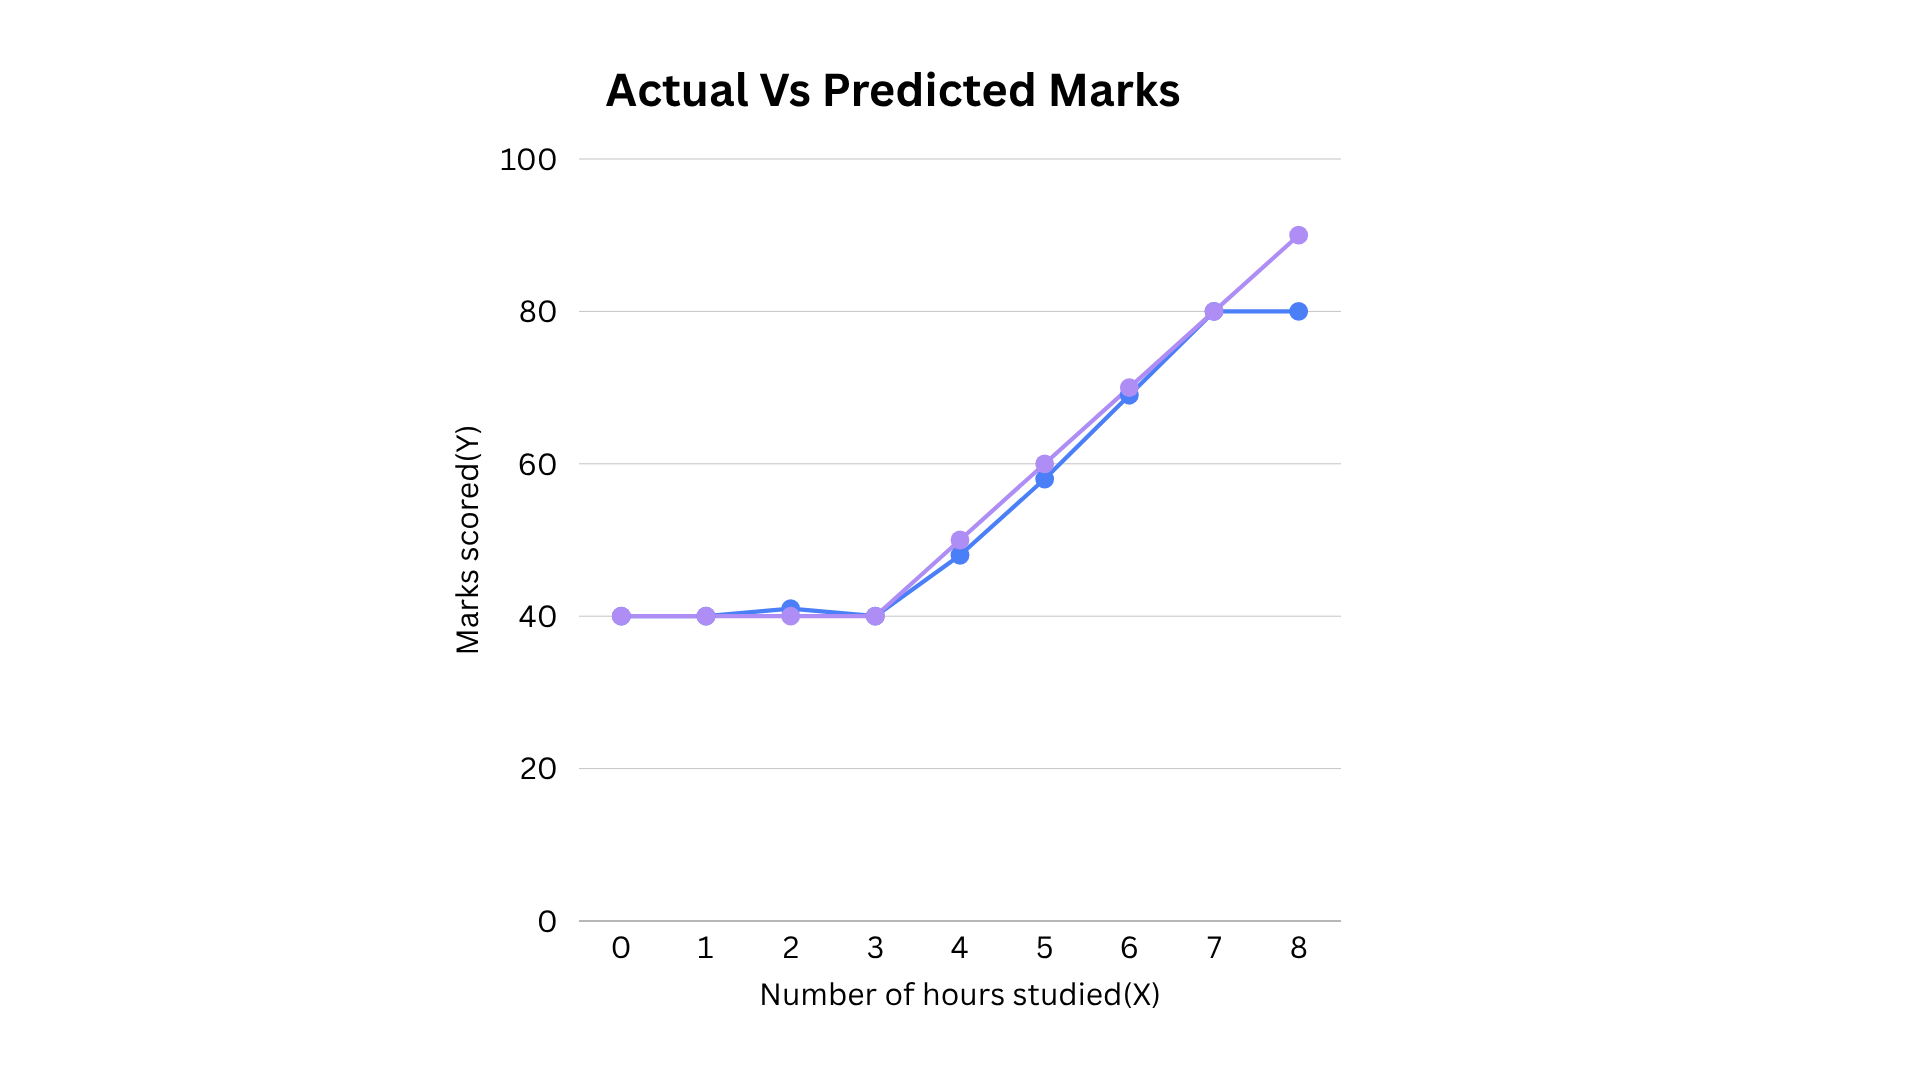
نمرههای واقعی و پیشبینیشده دقیقاً مطابقت ندارند، اما به هم نزدیک هستند. نمرهها به افزایش خود ادامه میدهند و در انتها مسطح نمیشوند، زیرا مقدار پس از آستانه ReLU همچنان به رشد خود ادامه میدهد.
خانم پولی از طریق این مثال نشان داده است که چگونه ReLU به مدلسازی روابط غیرخطی در دادهها کمک میکند.
پیشبینی قبولی/مردودی با استفاده از ReLU و سیگموئید
در اینجا خانم پولی از یک شبکه عصبی برای پیشبینی اینکه آیا یک دانشآموز در امتحان نهایی قبول میشود یا مردود، استفاده خواهد کرد. او فرض میکند که یک دانشآموز برای قبولی به حداقل ۵۰ نمره نیاز دارد. از این شبکه برای پیشبینی احتمال قبولی در امتحان استفاده خواهد شد.
مقدمه شماره ۱: راهاندازی شبکه
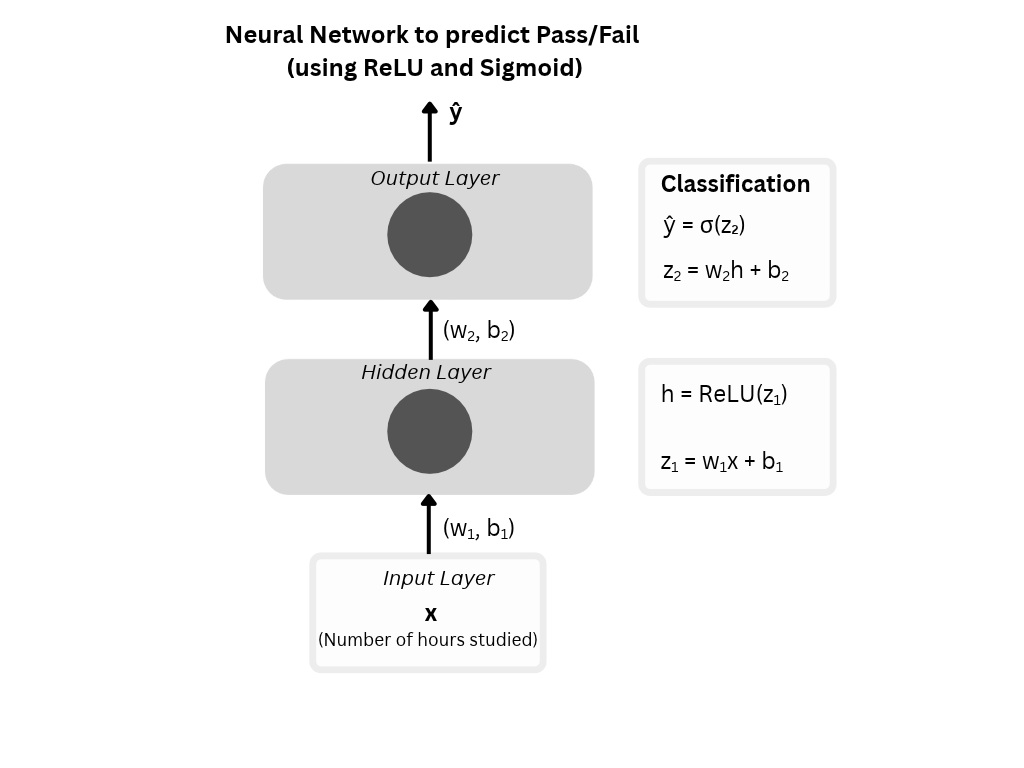
خانم پولی شبکه عصبی عمیق را با معادلات ساده به شکل زیر راهاندازی کرده است:
- لایه ورودی: تعداد ساعتهای مطالعه (x) در اینجا دریافت میشود.
- لایه پنهان: تبدیل خطی و تابع ReLU روی ورودی اعمال میشود. z₁ = w₁x + b₁, = x - 4 (w₁=1, b₁=-4) h = ReLU(z₁) = max(0, z₁)
- لایه خروجی: وضعیت قبولی/مردودی پس از اعمال تابع فعالسازی سیگموئید روی تبدیل خطی خروجی لایه پنهان (h) پیشبینی میشود. z₂ = w₂h + b₂ = 2h - 1 (w₂=2, b₂=-1) p = σ(z₂) = 1 / (1 + exp(-z₂)) ŷ = Pass, if p >= 0.5 ŷ = Fail, if p < 0.5
مقدمه شماره ۲: محاسبه پیشبینی قبولی/مردودی
فرض کنید او میخواهد نتیجه را برای دانشآموزی که ۳ ساعت مطالعه کرده است پیشبینی کند. کار او به این شکل انجام میشود:
    z₁ = w₁x + b₁, = x - 4 = 3 - 4 = -1
h = ReLU(z₁) = max(0, z₁) = max(0, -1) = 0
پیشبینی قبولی یا مردودی دانشآموز:
    z₂ = w₂h + b₂ = 2h - 1 = 2(0) - 1 = -1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-(-1))) ≈ 0.269
از آنجا که 0.269<0.5 است، نتیجه دانشآموز مردودی (Fail) است.
اکنون برای نتیجه دانشآموزی که ۵ ساعت مطالعه کرده است:
    z₁ = w₁x + b₁, = x - 4 = 5 - 4 = 1
h = ReLU(z₁) = max(0, z₁) = max(0, 1) = 1
پیشبینی قبولی یا مردودی دانشآموز:
    z₂ = w₂h + b₂ = 2h - 1 = 2(1) - 1 = 1
p = σ(z₂) = 1 / (1 + exp(-z₂)) = 1 / (1 + exp(-1)) ≈ 0.731
از آنجا که 0.731>0.5 است، نتیجه دانشآموز قبولی (Pass) است.
مقدمه شماره ۳: مقایسه پیشبینیها با نتایج واقعی
| تعداد ساعتهای مطالعه | نمره کسبشده | نتیجه واقعی | نمره پیشبینیشده | نتیجه پیشبینیشده |
|---|---|---|---|---|
| 0 | 40 | مردودی | 0.269 | مردودی |
| 1 | 40 | مردودی | 0.269 | مردودی |
| 2 | 41 | مردودی | 0.269 | مردودی |
| 3 | 40 | مردودی | 0.269 | مردودی |
| 4 | 48 | مردودی | 0.269 | مردودی |
| 5 | 58 | قبولی | 0.731 | قبولی |
| 6 | 69 | قبولی | 0.953 | قبولی |
| 7 | 80 | قبولی | 0.993 | قبولی |
| 8 | 80 | قبولی | 0.999 | قبولی |
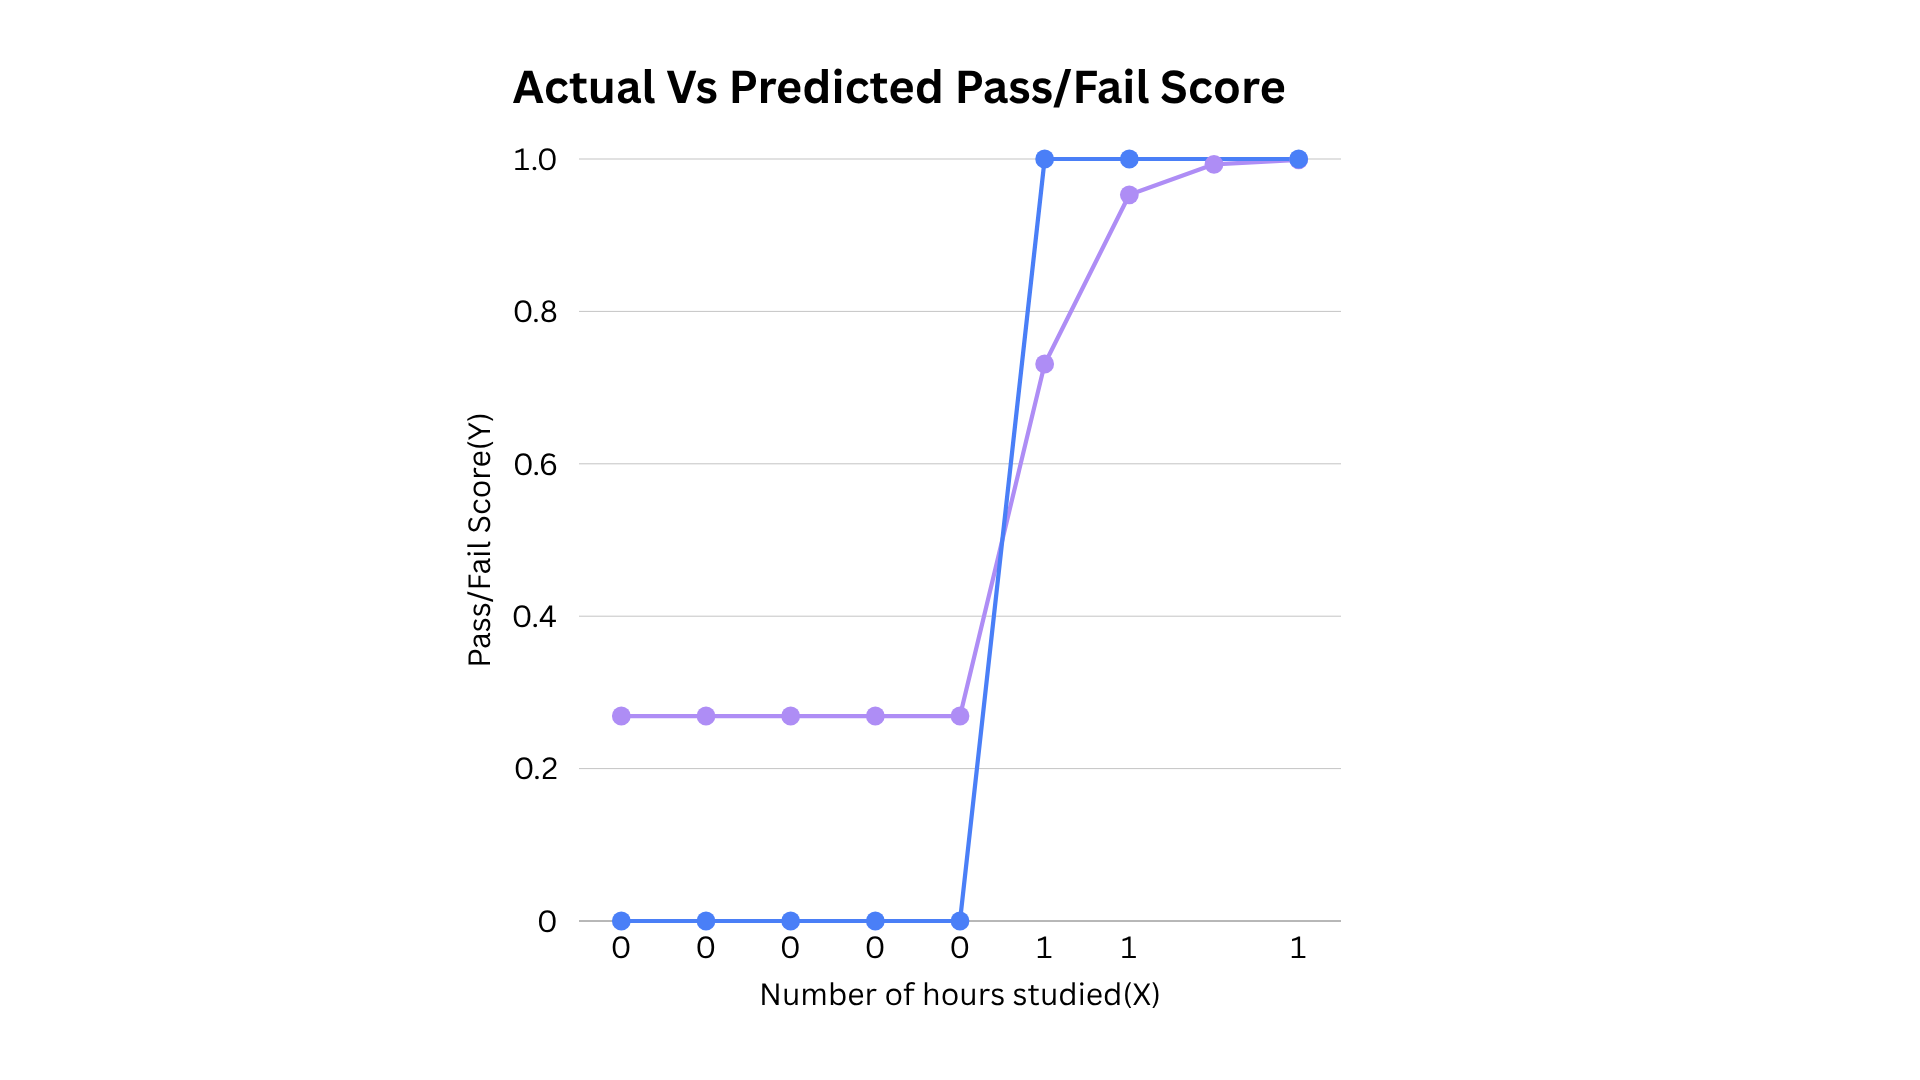
این شبکه، نتیجهی تمامی دانشآموزان را در این مثال بهدرستی دستهبندی میکند. با افزایش ساعت مطالعه به بیش از ۴ ساعت، نمرهی پیشبینیشده افزایش مییابد و احتمال پیشبینی قبولی را بیشتر میکند.
خانم پلی از طریق این مثال نشان داده است که چگونه ReLU و سیگموئید (sigmoid) در کنار یکدیگر کار میکنند. ReLU ورودی را در لایه پنهان تغییر میدهد و سیگموئید به تبدیل خروجی به نمرهای کمک میکند که میتوان از آن برای پیشبینی قبولی/رد شدن استفاده کرد.
نکات پایانی
مثالهای سادهای که در بالا نشان داده شد به ما کمک میکنند تا یک قانون مهم دربارهی شبکههای عصبی را درک کنیم: رابطهی بین خروجیها و ورودیها میتواند در بخشهای مختلف ورودی به شکلهای متفاوتی عمل کند. این روابط باید برای تولید نتایج معنادار از دادههای دنیای واقعی ثبت و مدلسازی شوند.
هنگامی که رابطه بین دادهها ساده و سازگار است، معادلهی یک خط صاف کفایت میکند. اما دادههای دنیای واقعی همیشه به همین سادگی نیستند. شبکههای عصبی با معرفی غیرخطی بودن، میتوانند از روابط خطی فراتر رفته و روابط پیچیدهی پنهان در دادهها را یاد بگیرند.
نظر مهندس بهمن آبادی: درک شهودی توابع فعالسازی مانند ReLU و سیگموئید، کلید اصلی عبور از محدودیت مدلهای خطی و توانایی شبکههای عصبی در مدلسازی الگوهای پیچیده دنیای واقعی است. به عنوان مدرس، همیشه تأکید میکنم که بدون غیرخطی بودن، عمیقترین شبکهها نیز چیزی بیش از یک رگرسیون خطی ساده نخواهند بود. معماری یک شبکه کارآمد، در گروی انتخاب هوشمندانه این توابع برای نگاشت دقیق ورودیها به خروجیهای احتمالاتی است.
منبع: https://www.freecodecamp.org/news/how-neural-networks-work-why-straight-lines-aren-t-enough/